 Victor Arias
TuPagoOnline es una pasarela de pagos construida en PHP y Laravel que pasó a correr sobre una infraestructura de alta disponibilidad en AWS: balanceo de carga, replicación con failover, colas para procesar transacciones, cifrado, WAF y anti-DDoS, monitorización y copias de seguridad. Tras el proyecto la plataforma sostiene un 99,98% de uptime y responde en 0,4 segundos.
| Cliente | TuPagoOnline |
| Sector | Pasarela de pagos |
| Servicio | Infraestructura IT |
| Tecnologías | PHP, Laravel, AWS, Balanceo de carga, Replicación y failover, Colas de transacciones, Monitorización, Seguridad y cifrado, WAF / anti-DDoS, Copias de seguridad |
| Duración | Más de 3 meses |
| Nuestro rol | Infraestructura de alta disponibilidad para la pasarela de pagos sobre AWS: balanceo de carga, replicación y failover, colas de transacciones, seguridad y cifrado, WAF y anti-DDoS, monitorización y copias de seguridad. |
| Publicado | 11 de julio de 2025 |
En una tienda, una caída de diez minutos se convierte en una anécdota. En una pasarela de pagos, esos diez minutos son operaciones que no se han hecho: clientes que intentaron pagar y no pudieron, comercios que se quedaron esperando una confirmación y una confianza que cuesta meses recuperar.
TuPagoOnline es una pasarela de pagos construida en PHP y Laravel que pasó a correr sobre una infraestructura de alta disponibilidad en AWS: balanceo de carga, replicación con failover, colas para procesar transacciones, cifrado, WAF y anti-DDoS, monitorización y copias de seguridad. Tras el proyecto la plataforma sostiene un 99,98% de uptime y responde en 0,4 segundos.
El reto: en pagos, una caída no es una molestia
Una plataforma de pagos tiene dos exigencias que no admiten matices: no puede perder operaciones y no puede quedarse sin responder. Y las dos se ponen a prueba justo cuando el sistema está más cargado.
El minuto de caída se cuenta en operaciones perdidas
Cuando la pasarela no responde, el comercio no ve un error técnico: ve una venta que no se cierra. Y si el fallo se repite, la consecuencia no es solo la operación perdida, es que el comercio busca otra pasarela, porque cobrar es lo único que no puede fallar en su negocio.
El pico no avisa
Los pagos se concentran: cierres de mes, campañas, días señalados. Un sistema dimensionado para el tráfico medio se queda corto precisamente el día que más importa, y ese día no se elige.
Una pasarela es un objetivo
Mover dinero y estar expuesto a internet es una combinación que atrae intentos de todo tipo: desde escaneos automáticos hasta ataques de volumen para dejarla fuera de servicio. La seguridad no es una capa que se añade después, es parte de la disponibilidad.
La solución: alta disponibilidad en AWS
La plataforma se reorganizó sobre AWS con redundancia en cada nivel: varios servidores atendiendo a la vez, una base de datos que replica, colas para que las transacciones no bloqueen la web y capas de seguridad delante de todo. La lógica es sencilla: si algo puede fallar, tiene que haber otra cosa haciendo su trabajo.
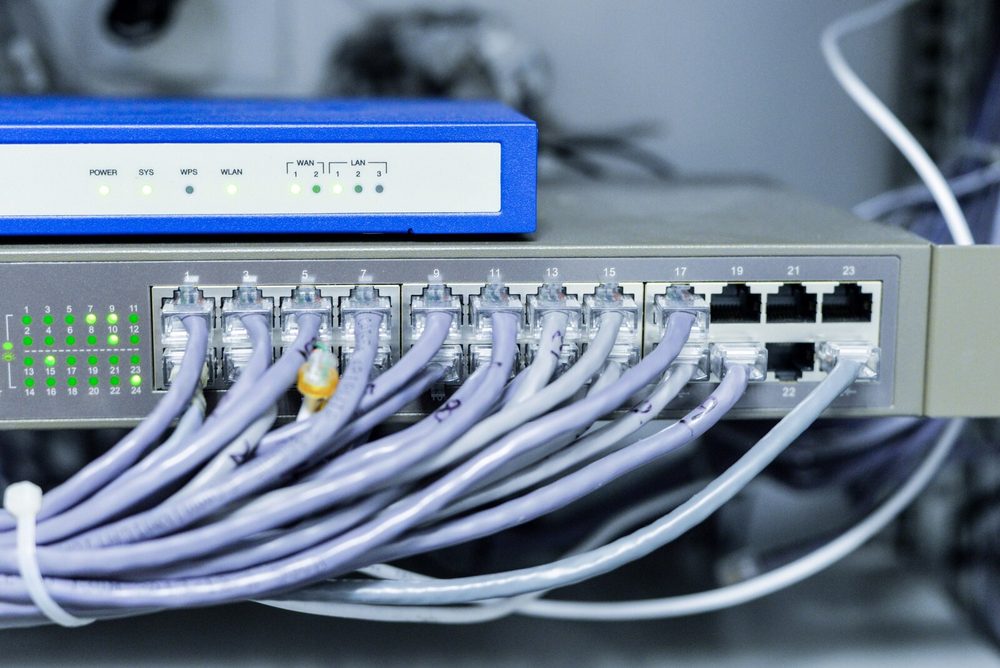 La alta disponibilidad se construye con redundancia: si un componente falla, otro tiene que estar haciendo su trabajo.
Balanceo de carga y varios servidores
El tráfico se reparte entre servidores en lugar de depender de uno solo, y si un nodo deja de responder los demás siguen atendiendo. Es lo que convierte una caída de servidor en un evento interno en lugar de una interrupción del servicio.
Replicación con failover y colas de transacciones
La base de datos mantiene réplicas y conmutación por error, así que el punto donde vive el dinero no es un único equipo. Las transacciones se procesan por colas, de forma que un pico de operaciones se encola y se resuelve en orden sin que la web deje de responder.
Seguridad, WAF y monitorización
Los datos se cifran en tránsito y en reposo, el WAF filtra peticiones maliciosas y el anti-DDoS absorbe los ataques de volumen. Todo ello con monitorización y alertas, porque en una pasarela el aviso tiene que llegar antes que la reclamación del comercio.
Cómo lo hicimos en más de tres meses
El trabajo se organizó en dos ideas: probar el fallo antes de que ocurra y vigilar lo que de verdad importa. En alta disponibilidad, lo que no se ha probado no se puede dar por resuelto.
 Detrás de cada pago hay una operación que no puede perderse: la infraestructura está para que el fallo no llegue al cliente.
Probar el fallo antes de que ocurra
Se forzaron fallos controlados —apagar nodos, cortar la conexión con la base de datos principal, simular carga— para comprobar que el sistema sigue atendiendo. Una infraestructura redundante que nunca se ha probado es una suposición, y en pagos las suposiciones se pagan caras.
Vigilar lo que de verdad importa
Se definieron las métricas que anticipan un problema: tiempo de respuesta de la API, longitud de las colas, errores por transacción y estado de las réplicas. Vigilar eso permite actuar antes de que el comercio note algo, que es el único momento útil para hacerlo.
Resultados
El proyecto se entregó con la plataforma corriendo sobre la infraestructura redundante, las colas y el cifrado en funcionamiento y la monitorización vigilando. Estas fueron las necesidades y cómo se resolvieron:
| Necesidad | Cómo se resolvió |
| Un servidor caído detiene los pagos | Balanceo de carga entre varios servidores |
| La base de datos como punto único de fallo | Replicación con conmutación por error |
| Picos que bloquean el procesamiento | Colas de transacciones |
| Datos de pago en tránsito y en reposo | Cifrado y controles de seguridad |
| Ataques de volumen o peticiones maliciosas | WAF y anti-DDoS |
| Enterarse de un fallo por el comercio | Monitorización, alertas y copias de seguridad |
Los resultados medidos del proyecto: la plataforma sostiene un 99,98% de uptime y responde en 0,4 segundos. Las dos cifras describen lo mismo desde dos ángulos: el sistema está disponible casi siempre y, cuando se usa, contesta rápido, que es exactamente lo que un comercio necesita para cobrar sin pensar en la infraestructura.
Qué necesita una plataforma de pagos
Si tu plataforma mueve dinero y no puedes permitirte que se caiga, estos son los puntos que deciden si aguanta:
- Redundancia en cada nivel, porque un componente único es un punto único de fallo.
- Conmutación por error probada, ya que una réplica que nunca se ha usado no se sabe si funciona.
- Colas para las transacciones, que evitan que un pico bloquee la atención normal.
- Cifrado y controles de seguridad, porque se manejan datos de pago de terceros.
- WAF y anti-DDoS, que protegen la disponibilidad frente a ataques, no solo la información.
- Monitorización de lo que anticipa el fallo, para actuar antes de que el cliente lo note.
Si tu plataforma maneja operaciones críticas y no tienes claro qué pasaría si falla un servidor, en la página de infraestructura IT contamos cómo lo trabajamos, y puedes escribirnos para revisarlo juntos.
Preguntas frecuentes
¿Qué significa alta disponibilidad en una pasarela de pagos?
Que la caída de un servidor no se note. Hay más de uno atendiendo, la base de datos replica y el tráfico se reparte entre ellos, de modo que un componente puede fallar sin que el pago se detenga. El objetivo no es no fallar nunca: es que un fallo no llegue al cliente.
¿Por qué importan las colas de transacciones?
Para que un pico no bloquee el sistema. Las operaciones se procesan en orden y de forma asíncrona, así que la web no se queda esperando a que termine cada transacción. En pagos, una cola bien montada es lo que separa «va lento» de «no responde».
¿Qué protegen el WAF y el anti-DDoS en una pasarela?
Una pasarela de pagos es un objetivo evidente: mueve dinero y está expuesta a internet. El WAF filtra peticiones maliciosas y el anti-DDoS evita que un ataque de volumen deje fuera a los clientes legítimos. Sin esas dos capas, la disponibilidad depende de que nadie decida atacarte.
¿Cuánto tarda montar una infraestructura de alta disponibilidad?
Este proyecto llevó más de tres meses. El calendario lo marcan el balanceo y los servidores redundantes, la replicación con failover, las colas de transacciones, el cifrado, el WAF y el anti-DDoS, la monitorización y las copias de seguridad.